Inhaltsverzeichnis
- Crawlen, Indexieren, Ranken: drei Schritte, nicht einer
- Die Statusmeldungen der Search Console in Klartext
- Die häufigsten Ursachen, nach Häufigkeit sortiert
- Der häufigste Fall: die Seite hat keinen eigenen Zweck
- Hebel 1: interne Verlinkung
- Hebel 2: eigenständige Inhalte
- Hebel 3: Vertrauen für die ganze Domain
- So gehst du bei einem Indexierungsproblem vor
- Sonderfall: Onlineshops und große Websites
- Wie du die Ursache in zwanzig Minuten eingrenzt
- Was nicht hilft
- Ein Beispiel aus der Praxis
- Wenn Seiten wieder aus dem Index verschwinden
- Neue Seiten schneller in den Index bekommen
- Häufige Fragen
- Fazit
- Quellen und weiterführende Links
Nur indexierte Seiten können ranken. Dieser Beitrag erklärt den Unterschied zwischen Crawlen und Indexieren, übersetzt die Statusmeldungen der Search Console in Klartext und zeigt die drei Hebel, die Seiten zuverlässig in den Index bringen.
Das Wichtigste in Kürze
- Nicht jede Seite, die Google kennt, landet im Index. Crawlen und Indexieren sind zwei getrennte Schritte.
- Die häufigste Ursache ist kein technischer Fehler, sondern ein Inhalt ohne eigenen Zweck.
- Der stärkste Hebel ist die interne Verlinkung: eine Seite, auf die nichts verweist, wirkt unwichtig.
- Die Search Console nennt je URL einen Status. Der sagt, was passiert ist, aber selten warum.
- Indexierung von Hand zu beantragen hilft für einzelne Seiten, nicht als Dauerlösung.
Der Fall kommt in fast jedem Projekt vor: Neue Seiten sind seit Wochen online, in der Suche findet man sie nicht, und in der Search Console steht ein Satz, der alles und nichts bedeutet. Das ist frustrierend, hat aber fast immer eine klare Ursache.
Ich gehe hier den Weg durch, den ich auch bei Kunden gehe: erst das Ausschließen der technischen Bremsen, dann die Statusmeldungen lesen, dann die drei Hebel, die wirklich etwas bewegen.
Crawlen, Indexieren, Ranken: drei Schritte, nicht einer
Sichtbarkeit bei Google läuft in Stufen, und an jeder kann es hängen bleiben.
- Finden: Google muss die Adresse überhaupt kennen, über einen Link oder über die Sitemap.
- Crawlen: Der Googlebot ruft die Seite ab und liest sie.
- Indexieren: Google entscheidet, ob die Seite in den Index aufgenommen wird.
- Ranken: Erst jetzt kann die Seite überhaupt zu einer Suchanfrage erscheinen.
Die meisten Probleme entstehen zwischen Schritt zwei und drei. Google kennt die Seite, hat sie gelesen und entscheidet sich trotzdem dagegen. Das ist kein Fehler im System, sondern eine Bewertung.
Wichtig zu wissen: Google indexiert längst nicht mehr alles, was technisch erreichbar ist. Die Menge an Seiten im Netz wächst schneller als die Bereitschaft, sie alle zu speichern. Wer aufgenommen werden will, muss einen Grund liefern.
- Google hat die Seite abgerufen und sich gegen die Aufnahme entschieden.
- Fast immer ein Hinweis auf einen austauschbaren oder zu dünnen Inhalt.
- Hebel: Inhalt vertiefen, eigenständig machen, intern verlinken.
- Erneutes Beantragen ändert nichts, solange die Seite gleich bleibt.
- Google kennt die Adresse, hat sie aber noch gar nicht gelesen.
- Meist schwache interne Verlinkung oder sehr viele ähnliche Seiten.
- Hebel: bessere Verlinkung, klarere Struktur, saubere Sitemap.
- Bei großen Websites auch eine Frage der Crawl-Kapazität.
Die Statusmeldungen der Search Console in Klartext
Der Bericht zur Indexierung listet je Adresse einen Status. Die Formulierungen sind gewöhnungsbedürftig, deshalb hier die häufigsten in einfacher Sprache.
Durch robots.txt blockiert
Du hast Google verboten, die Seite zu lesen. Das ist ein technischer Riegel und in der Regel ein Versehen aus einem Plugin oder aus der Entwicklungsphase.
Durch noindex ausgeschlossen
Auf der Seite steht ausdrücklich, dass sie nicht in den Index soll. Häufigster Fall: Die Einstellung stammt noch aus der Bauphase der Website und wurde beim Start nicht entfernt.
Alternative Seite mit richtigem kanonischen Tag
Die Seite verweist selbst auf eine andere als die maßgebliche Fassung. Das ist gewollt, wenn es zwei ähnliche Adressen gibt. Es ist ein Problem, wenn das Canonical versehentlich überall auf die Startseite zeigt, was bei falsch eingerichteten Systemen regelmäßig vorkommt.
Duplikat, Google hat eine andere Seite gewählt
Google hält deine Seite für eine Variante einer anderen und hat sich für die andere entschieden. Meistens sind sich zwei eigene Seiten zu ähnlich, manchmal steht der Text auch woanders im Netz.
Soft 404
Die Seite liefert technisch ein „alles in Ordnung", wirkt inhaltlich aber wie eine Fehlerseite. Typisch bei leeren Ergebnislisten, leeren Kategorien oder Seiten, die nur aus einer Überschrift bestehen.
Seite mit Weiterleitung
Die Adresse leitet weiter, indexiert wird das Ziel. Das ist normal. Zum Problem wird es, wenn die Sitemap voller weitergeleiteter Adressen steht.
Gecrawlt, zurzeit nicht indexiert
Der häufigste Status bei Content-Problemen. Google hat gelesen und für nicht aufnahmewürdig befunden. Hier hilft nur ein besserer Inhalt und mehr interne Verlinkung.
Praxis-Tipp
Bevor du an Texten feilst: Prüfe die Seite einmal in der URL-Prüfung der Search Console. Dort steht, ob ein noindex, eine Blockade oder ein Canonical im Spiel ist. Diese drei verhindern die Aufnahme vollständig, egal wie gut der Text ist.
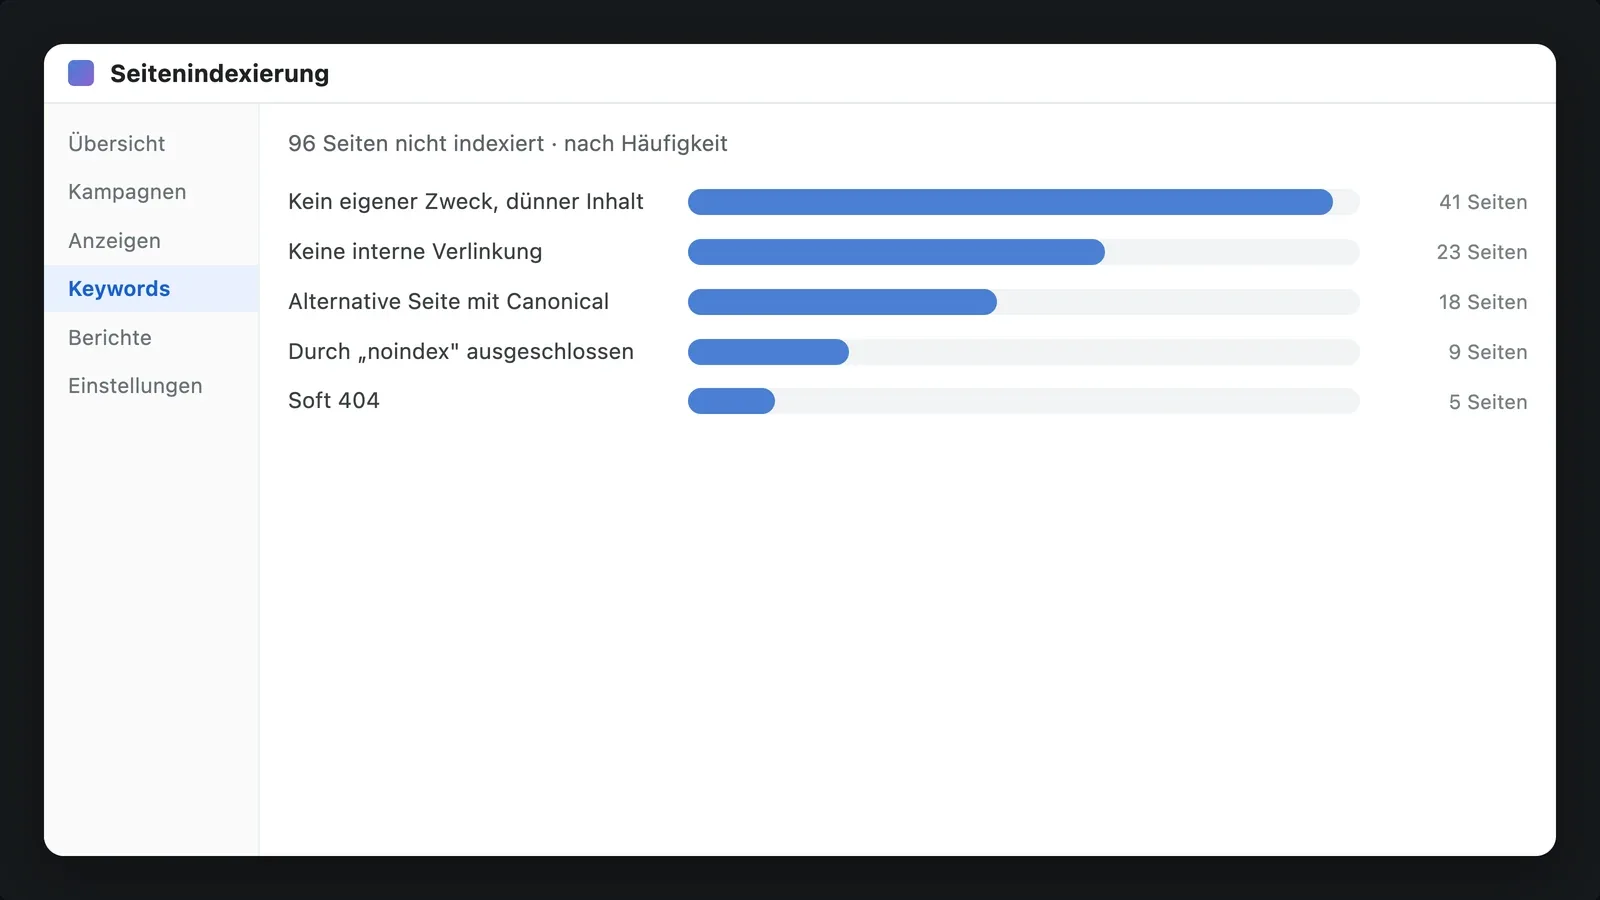
Die häufigsten Ursachen, nach Häufigkeit sortiert
Die Reihenfolge überrascht viele. Die Suche nach dem technischen Fehler ist beliebt, weil sie sich nach Handwerk anfühlt. In den meisten Fällen ist die Antwort aber unbequemer: Die Seite sagt nichts, was nicht schon woanders steht.
Der häufigste Fall: die Seite hat keinen eigenen Zweck
Wenn ich eine Seite mit dem Status „gecrawlt, zurzeit nicht indexiert" bekomme, stelle ich drei Fragen. Sie klären in den meisten Fällen schon alles.
- Was steht auf dieser Seite, das nicht auch auf zehn anderen Seiten im Netz steht?
- Für welche konkrete Frage ist diese Seite die beste Antwort?
- Würde ich diese Seite jemandem schicken, der mich genau das fragt?
Wenn eine der Antworten unklar bleibt, hilft kein technischer Eingriff. Dann muss die Seite entweder deutlich besser werden oder mit einer anderen zusammengelegt.
Zusammenlegen ist dabei fast immer der schnellere Weg. Zwei schwache Texte zu einem guten machen, die alte Adresse dauerhaft weiterleiten. Das entfernt gleichzeitig ein Duplikat und stärkt die verbleibende Seite.
Eine Seite, die nicht indexiert wird, ist selten ein technisches Problem. Meistens ist sie schlicht überflüssig.
Hebel 1: interne Verlinkung
Der stärkste und am meisten unterschätzte Hebel. Eine Seite, auf die keine andere verweist, ist eine Waisenseite. Google findet sie schwer und behandelt sie als unwichtig, weil offenbar nicht einmal du selbst auf sie zeigst.
Was konkret zu tun ist
- Jede neue Seite aus mindestens zwei thematisch passenden Seiten heraus verlinken, im Fließtext, nicht in einem Kasten am Ende.
- Wichtige Seiten in die Navigation oder in eine Übersichtsseite aufnehmen, damit sie in wenigen Klicks erreichbar sind.
- Verweise mit einem Text versehen, der das Ziel beschreibt. „Mehr erfahren" hilft weder Nutzern noch Google.
- Alte Beiträge regelmäßig durchgehen und auf neue Seiten verlinken. Das kostet zehn Minuten je Beitrag und wirkt oft innerhalb von Tagen.
In mehreren Projekten war das die einzige Maßnahme, die nötig war. Seiten, die monatelang mit „gefunden, zurzeit nicht indexiert" standen, waren nach zwei internen Links binnen einer Woche im Index.
Hebel 2: eigenständige Inhalte
Google indexiert ungern zwei Seiten, die dasselbe sagen. Das betrifft nicht nur kopierte Texte, sondern auch die vielen fast gleichen Seiten, die durch Filter, Varianten oder Vorlagen entstehen.
Besonders betroffen sind programmatisch erzeugte Seiten, etwa je Stadt oder je Branche. Wenn sich zwanzig Seiten nur im Ortsnamen unterscheiden, ist das für Google eine Seite in zwanzig Ausführungen, und neunzehn davon fliegen raus.
Woran du das erkennst
- Der Status „Duplikat, Google hat eine andere Seite gewählt" taucht bei mehreren Adressen auf.
- Von zwanzig ähnlichen Seiten sind nur zwei oder drei im Index.
- Bei der Suche nach einem wörtlichen Satz aus deinem Text erscheint eine andere eigene Seite.
Die Lösung ist keine technische Einstellung, sondern Substanz: eigene Beispiele, eigene Zahlen, eigene Bilder, ein erkennbarer Grund, warum es diese Seite gibt. Wo das nicht möglich ist, gehört die Seite nicht ins Netz.
Hebel 3: Vertrauen für die ganze Domain
Der dritte Hebel wirkt nicht auf die einzelne Seite, sondern auf alles. Eine Domain, der Google mehr zutraut, wird häufiger, tiefer und schneller gecrawlt.
Dieses Vertrauen entsteht aus Verweisen anderer Websites, aus einer erkennbaren Identität und aus der Zeit. Wichtig ist Qualität vor Menge: Wenige Verweise von echten, thematisch passenden Seiten wirken stärker als hundert Einträge aus Linkverzeichnissen.
Für eine neue Seite reicht manchmal schon ein einziger guter Verweis von außen, damit Google sie überhaupt ernst nimmt. Das ist auch der Grund, warum Beiträge, über die jemand spricht, fast immer sofort im Index landen.
So gehst du bei einem Indexierungsproblem vor
- 1
URL prüfen
In der Search Console die betroffene Adresse eingeben. Steht dort noindex, robots.txt oder ein fremdes Canonical? Dann ist die Ursache gefunden.
- 2
Status verstehen
Gecrawlt oder nur gefunden? Beim ersten Fall ist der Inhalt das Thema, beim zweiten die Verlinkung.
- 3
Interne Links setzen
Zwei bis drei Verweise aus passenden Seiten, im Fließtext. Danach die Seite einmal zur Prüfung einreichen.
- 4
Inhalt schärfen
Wenn die Seite austauschbar ist: vertiefen, mit eigenen Beispielen versehen oder mit einer anderen zusammenlegen.
- 5
Zwei Wochen warten
Danach erneut prüfen. Wenn sich nichts bewegt hat, liegt es an der Domain insgesamt, nicht an dieser Seite.
Der letzte Punkt ist wichtig. Wenn ganze Bereiche einer Website nicht aufgenommen werden, ist die einzelne Seite das falsche Objekt. Dann geht es um Struktur, Menge und Qualität insgesamt.
Sonderfall: Onlineshops und große Websites
Bei Shops sieht das Bild oft dramatisch aus: Tausende Adressen, ein Bruchteil davon im Index. Das ist meistens kein Fehler, sondern das erwartbare Ergebnis der Systemarchitektur.
Filter, Sortierungen und Varianten erzeugen Adressen in großer Zahl. Ein Shop mit 500 Produkten kommt schnell auf 50.000 abrufbare Adressen, von denen die allermeisten keinen eigenen Zweck haben.
Was hier wirklich hilft
- Filterseiten technisch von der Indexierung ausnehmen, aber weiterhin bedienbar lassen.
- Kategorien mit eigenem Text versehen, der über die reine Produktliste hinausgeht.
- Varianten desselben Produkts über ein sauberes Canonical zusammenführen.
- Ausverkaufte Produkte nicht löschen, sondern die Seite behalten und auf Alternativen verweisen.
Erst wenn diese Grundlagen stimmen, lohnt der Blick auf die Crawl-Kapazität. Bei kleinen und mittleren Websites ist sie praktisch nie die Ursache, bei Shops ab etwa zehntausend echten Seiten dagegen schon.
Wie du die Ursache in zwanzig Minuten eingrenzt
Ein Ablauf, der ohne Werkzeuge auskommt und in fast jedem Fall die Richtung klärt.
- In der Search Console den Bericht zur Indexierung öffnen und die Gruppen nach Anzahl sortieren. Die größte Gruppe ist dein eigentliches Thema.
- Aus dieser Gruppe drei Adressen herausgreifen und einzeln prüfen. Wenn alle drei denselben Status haben, gilt die Diagnose für die ganze Gruppe.
- Eine der Seiten aufrufen und ehrlich lesen. Würde diese Seite jemandem helfen, der genau diese Frage hat?
- Prüfen, wie viele interne Verweise auf diese Seite zeigen. Null oder einer erklärt fast alles.
- Entscheiden: verbessern, zusammenlegen oder bewusst ausschließen. Nichts zu entscheiden ist die schlechteste der drei Möglichkeiten.
Am Ende dieser zwanzig Minuten steht in der Regel keine technische Aufgabe, sondern eine inhaltliche. Genau deshalb bleibt sie oft so lange liegen.
Was nicht hilft
Indexierung immer wieder von Hand beantragen
Die Funktion ist für Einzelfälle gedacht, etwa nach einer Korrektur. Dieselbe Adresse dreimal einzureichen, ändert nichts an der Bewertung und verbraucht nur dein Tageskontingent.
Dienste, die Indexierung versprechen
Es gibt Anbieter, die gegen Geld eine Aufnahme in den Index versprechen. Was sie tun, sind Signale von außen, die entweder wirkungslos oder riskant sind. Kein seriöser Weg führt an Inhalt und Verlinkung vorbei.
Die Sitemap immer wieder neu einreichen
Die Sitemap ist ein Hinweis, keine Anweisung. Sie hilft beim Finden, nicht beim Bewerten. Wenn eine Seite dort steht und trotzdem nicht aufgenommen wird, liegt es nie an der Sitemap.
Mehr Seiten veröffentlichen
Der verbreitetste Reflex und der schädlichste. Wenn Google die vorhandenen Seiten nicht aufnimmt, verschlimmert jede weitere dünne Seite das Bild. Weniger und besser ist hier fast immer die richtige Richtung.
Ein Beispiel aus der Praxis
Ein Dienstleister mit rund 120 Seiten, davon 34 im Index. Die fehlenden waren überwiegend Standortseiten, alle nach demselben Muster gebaut, mit ausgetauschtem Ortsnamen.
Die Search Console zeigte zwei Muster: die Hälfte mit „Duplikat, Google hat eine andere Seite gewählt", die andere Hälfte mit „gefunden, zurzeit nicht indexiert". Beides zusammen ist ein ziemlich klares Urteil.
Wir haben aus 60 Standortseiten 12 gemacht, für die Orte, in denen der Kunde wirklich arbeitet. Diese zwölf bekamen eigene Referenzen, eigene Bilder und je einen eigenen Abschnitt zur Lage vor Ort. Die übrigen 48 wurden auf die passende neue Seite weitergeleitet.
Nach sechs Wochen waren elf der zwölf im Index, und die Zahl der indexierten Seiten insgesamt war von 34 auf 51 gestiegen. Es kamen also mehr Seiten in den Index, obwohl es weniger Seiten gab. Genau das ist der Punkt, den viele nicht glauben, bevor sie ihn gesehen haben.
Wenn Seiten wieder aus dem Index verschwinden
Auch das ist normal und kein Anlass zur Panik. Google räumt regelmäßig auf und entfernt Seiten, die nie aufgerufen werden oder deren Inhalt veraltet ist.
Zum Warnsignal wird es, wenn ganze Bereiche verschwinden oder wenn es Seiten trifft, die vorher Zugriffe hatten. Dann lohnt der Blick auf drei Dinge: Hat sich die Seite geändert, hat sich die Verlinkung geändert, oder ist ein größeres Update ausgerollt worden?
In allen anderen Fällen gilt: Eine Seite, die niemand besucht und auf die niemand verlinkt, verliert ihren Platz. Das ist unangenehm, aber es ist dieselbe Logik, die dafür sorgt, dass gute Seiten ihren Platz behalten.
Neue Seiten schneller in den Index bekommen
Wenn eine Seite neu ist, geht es nicht um Reparatur, sondern um einen guten Start. Vier Dinge, die in dieser Reihenfolge wirken.
Erstens die Verlinkung, noch vor der Veröffentlichung. Überlege dir, von welchen zwei bestehenden Seiten aus verlinkt wird, und setze die Verweise am selben Tag. Eine Seite, die von Anfang an eingebunden ist, wird deutlich schneller gefunden.
Zweitens die Sitemap. Sie sollte die neue Adresse automatisch enthalten und ein Änderungsdatum tragen, das der Wahrheit entspricht. Ein Datum, das bei jedem Aufruf auf heute springt, wird von Google ignoriert.
Drittens die einmalige Prüfung in der Search Console mit der Schaltfläche zur Indexierung. Einmal, nicht dreimal. Das beschleunigt das Finden, ersetzt aber nicht die Bewertung.
Viertens ein Signal von außen, wenn es sich anbietet: ein Beitrag in einem Newsletter, ein Hinweis in einem Fachforum, eine Erwähnung bei jemandem, der über das Thema schreibt. Genau solche Seiten sind meistens binnen Stunden im Index.
Häufige Fragen
Wie lange dauert die Indexierung normalerweise?
Bei einer etablierten Website mit guter Verlinkung: Stunden bis wenige Tage. Bei einer neuen Domain: ein bis vier Wochen. Wenn nach vier Wochen nichts passiert ist, liegt es nicht an der Wartezeit.
Wie viele Seiten sollten indexiert sein?
Es gibt keine Zielzahl. Sinnvoll ist der Vergleich: Wie viele Seiten sollen indexiert sein, und wie viele sind es? Alles, was du bewusst ausschließt, gehört nicht in die Rechnung.
Schadet es, wenn viele Seiten nicht indexiert sind?
Einzelne nicht. Wenn aber ein großer Teil der Website nicht aufgenommen wird, ist das ein Qualitätsurteil über das Ganze, und es wirkt sich auch auf die Seiten aus, die drin sind.
Hilft eine schnellere Website bei der Indexierung?
Indirekt ja. Schnelle Seiten kann Google in derselben Zeit häufiger abrufen, was bei großen Websites eine Rolle spielt. Bei einer Website mit fünfzig Seiten ist das nicht der Engpass.
Was ist mit IndexNow und ähnlichen Diensten?
IndexNow meldet neue Adressen an Bing und Yandex, nicht an Google. Das ist nützlich und kostet nichts, ersetzt aber die Arbeit an Inhalt und Verlinkung nicht.
Kann ich prüfen, ob eine bestimmte Seite im Index ist?
Ja, mit der URL-Prüfung in der Search Console. Die Abfrage über den site-Befehl in der Suche gibt nur einen groben Eindruck und ist für einzelne Adressen unzuverlässig.
Mein Beitrag steht im Index, rankt aber nicht. Was jetzt?
Das sind zwei verschiedene Themen. Indexiert heißt aufgenommen, nicht bewertet. Wenn eine Seite drin ist und trotzdem keine Zugriffe bekommt, geht es um Wettbewerb, Suchabsicht und Verlinkung, nicht mehr um Indexierung.
Sollte ich Seiten ohne Zugriffe löschen?
Nicht pauschal. Prüfe zuerst, ob die Seite einen Zweck erfüllt, den man nicht an Zugriffen misst, etwa als Erklärseite für Kunden. Wenn nicht, ist Zusammenlegen mit Weiterleitung fast immer besser als Löschen.
Wie oft sollte ich den Indexierungsbericht ansehen?
Einmal im Monat reicht, und dann auf die Entwicklung der Gruppen schauen, nicht auf einzelne Adressen. Wenn eine Gruppe deutlich wächst, hat sich etwas Strukturelles geändert.
Fazit
Indexierungsprobleme wirken technisch, sind es aber selten. In der überwiegenden Zahl der Fälle sagt Google mit dem Status nur eines: Diese Seite ist nicht wichtig genug, weder für dich noch für sonst jemanden.
Die Gegenmittel sind entsprechend unspektakulär. Verlinke deine wichtigen Seiten so, dass man sie findet. Gib jeder Seite einen eigenen Grund zu existieren. Und sorge dafür, dass es außerhalb deiner Website Belege dafür gibt, dass es dich gibt.
Wenn du wissen willst, wie lange der Aufbau danach dauert, steht das in Wie lange dauert SEO. Und wenn jemand von außen draufschauen soll: Wie ich als SEO-Freelancer arbeite, steht auf der verlinkten Seite.
Was mache ich mit alten Seiten, die niemand mehr braucht?
Weiterleiten, nicht löschen, wenn es eine passende Nachfolgeseite gibt. Wenn nicht, darf die Seite verschwinden und eine saubere Fehlerseite liefern. Was du vermeiden solltest, ist der Zwischenzustand: Seiten, die niemand pflegt, die aber weiter im Index stehen und den Eindruck der ganzen Website mitprägen.
Wirkt sich eine große Aufräumaktion negativ aus?
Kurzfristig schwanken die Zahlen, das ist normal. Wichtig ist, dass jede entfernte Adresse ein sinnvolles Ziel bekommt und dass die interne Verlinkung danach stimmt. In den Projekten, in denen ich das begleitet habe, lag die Sichtbarkeit nach sechs bis acht Wochen über dem Ausgangswert.
Quellen und weiterführende Links
- Google Search Central: Bericht zur Indexierung, alle Statusmeldungen im Original.
- Google Search Central: URL-Prüfung, wie man eine einzelne Adresse prüft.
- Google Search Central: hilfreiche Inhalte, woran Google Qualität festmacht.